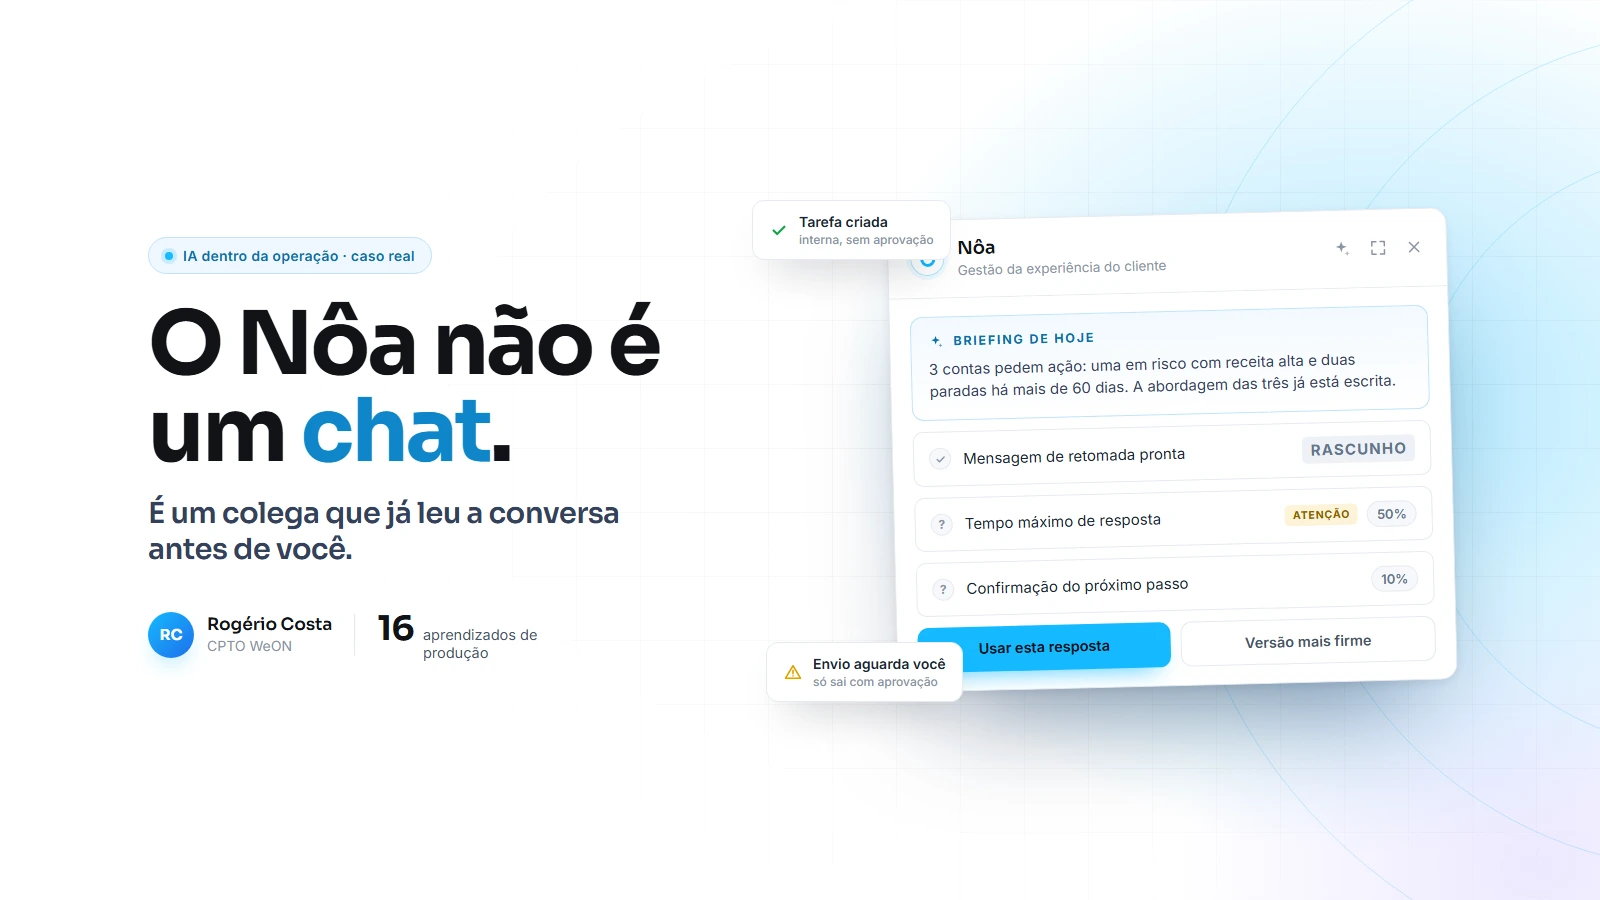
O Nôa não é um chat: é um colega que já leu a conversa antes de você
 Rogério Costa· CPTO WeON18 de agosto de 2026 · 18 min de leitura
Neste artigo
- A cena que originou tudo
- Um cérebro, várias bocas
- O que ele faz hoje, camada por camada
- 1. Contexto: quem é essa pessoa, de verdade
- 2. Briefing do dia
- 3. Radar e plano do dia
- 4. Script do atendimento, ao vivo
- 5. A varinha: mensagem pronta, com tom
- 6. Envio de verdade: um para um, template e transmissão
- 7. Vigia: o Nôa cobra sozinho
- 8. A ronda interpretativa
- 9. Tarefas, agendamento e o dia seguinte
- 10. Documentos no layout do cliente
- 11. Conhecimento do produto
- A arquitetura em uma frase
- Os aprendizados
- 1. Entregue decisão, não informação
- 2. Trilho determinístico ganha de instrução, sempre
- 3. Suba o modelo antes de subir o raciocínio
- 4. Proibição em excesso paralisa tanto quanto instrução de menos
- 5. A descrição da ferramenta ensina mais que o prompt
- 6. Rede no parser vale mais que instrução no prompt
- 7. Botão fixo na tela é pedido ambíguo
- 8. Identidade é feature, não detalhe
- 9. HTTP 200 não é entrega
- 10. Memória compartilhada é vazamento esperando acontecer
- 11. O portão tem que falar a língua de quem bate nele
- 12. Cache é decisão de arquitetura, não otimização posterior
- 13. Cuidado com o fantasma do seu próprio ambiente
- 14. Meça o que o usuário recebeu, não o que o agente chamou
- 15. Custo é design, não fatura
- 16. Lições de processo, que doem mais que as de código
- O modelo mental que ficou: autonomia por degraus
- Se você vai construir o seu
Como um agente de IA saiu da demonstração e virou parte da operação de atendimento, e as lições que só aparecem quando gente de verdade depende dele.
A cena que originou tudo
Uma atendente com a fila aberta, quatorze conversas no dia, um cliente que sumiu há três meses e uma pergunta na cabeça: "o que eu falo com essa pessoa?"
A informação para responder isso existe. Está no histórico, no cadastro, na receita da conta, na última avaliação, no chamado que abriu e não fechou, na campanha que ela recebeu semana passada. Está tudo lá. E é exatamente por isso que ninguém olha: a informação está espalhada em seis telas e a fila não espera.
O erro clássico de quem constrói IA para atendimento é atacar o problema errado. A operação não sofre de falta de dado. Sofre de falta de decisão. Painel novo não resolve: vira mais uma aba aberta. O que resolve é alguém chegar e dizer "esse aqui é o próximo, por este motivo, e a mensagem está pronta, é só revisar".
O Nôa foi construído para ser esse alguém.
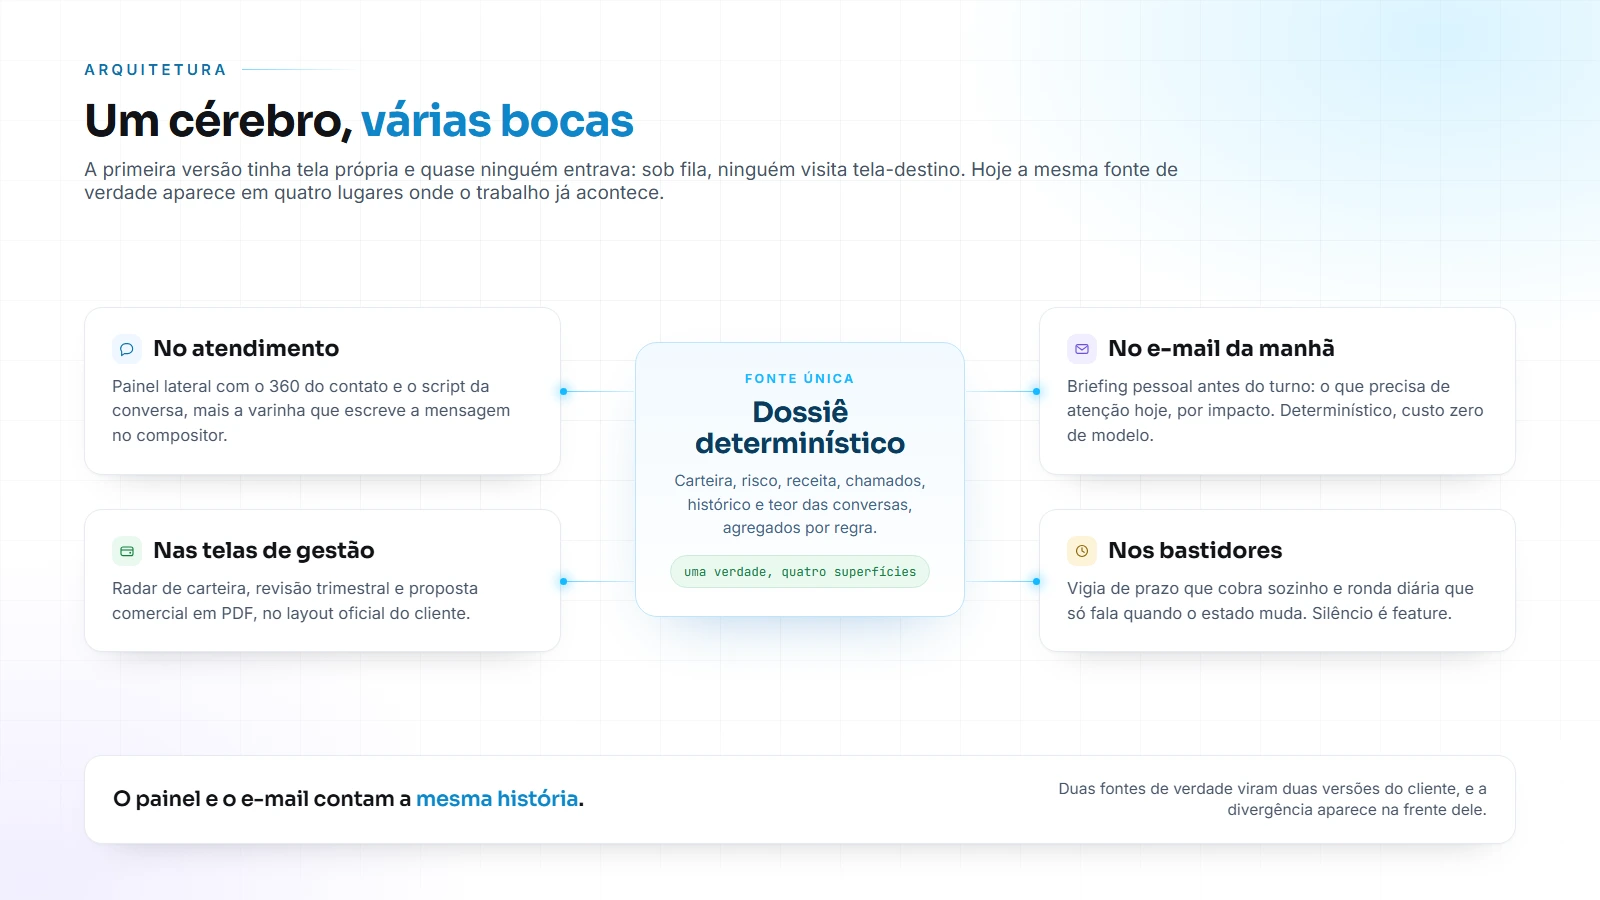
Um cérebro, várias bocas
A primeira versão do Nôa tinha uma tela própria. Bonita, completa, com radar de carteira, risco, receita em risco, plano do dia. E quase ninguém entrava.
O diagnóstico foi desconfortável e virou princípio: sob fila, ninguém visita tela-destino. Se a inteligência mora num lugar onde a pessoa precisa decidir ir, ela não existe. Ela tem que encontrar a pessoa no meio do fluxo.
Hoje o Nôa é um cérebro só, com várias bocas:
- No atendimento, como painel lateral e como varinha no compositor da mensagem.
- No e-mail da manhã, como briefing do dia, antes do turno começar.
- Nas telas de gestão, como radar de carteira, revisão trimestral e proposta comercial.
- Nos bastidores, como vigia de prazo e ronda periódica.
Todas essas bocas comem da mesma fonte de verdade. Isso não é elegância arquitetural: é a única forma de o painel e o e-mail não contarem histórias diferentes na frente do cliente.
O que ele faz hoje, camada por camada
1. Contexto: quem é essa pessoa, de verdade
O ponto de partida é um diagnóstico determinístico do cliente. Ele agrega as fichas do mesmo número (é comum o mesmo humano existir em quatro cadastros diferentes), puxa a carteira, a empresa, a receita da conta, os chamados dos últimos trinta dias com comparação de faixa, e lê o teor das últimas conversas. E declara quantas fichas analisou, para que a resposta seja auditável.
Isso é o oposto de "pergunta ao modelo o que ele acha". É consulta, agregação e regra. O modelo entra só depois, para conversar sobre um material que já está correto.
2. Briefing do dia
Todo dia, antes do turno, cada pessoa com carteira recebe um e-mail com o que precisa de atenção. São dezenas de e-mails, todos os dias, cada um diferente do outro.
O detalhe importante: esse briefing custa zero de modelo de linguagem. Ele é montado por regra, com dado ao vivo. A IA aparece apenas na camada opcional que redige o rascunho da abordagem. Um agente que gasta dinheiro para contar linhas de uma tabela é um agente mal desenhado.
3. Radar e plano do dia
Na visão de gestão, o Nôa devolve uma lista priorizada por impacto: saúde crítica, atenção, saudável; receita em risco; tarefas atrasadas pela mesma régua do painel oficial; conta agrupada (empresa e contatos contam como uma ação, não como dez); e, no fim, uma frase que muda a natureza da ferramenta: "eu executo tudo, se você aprovar".
4. Script do atendimento, ao vivo
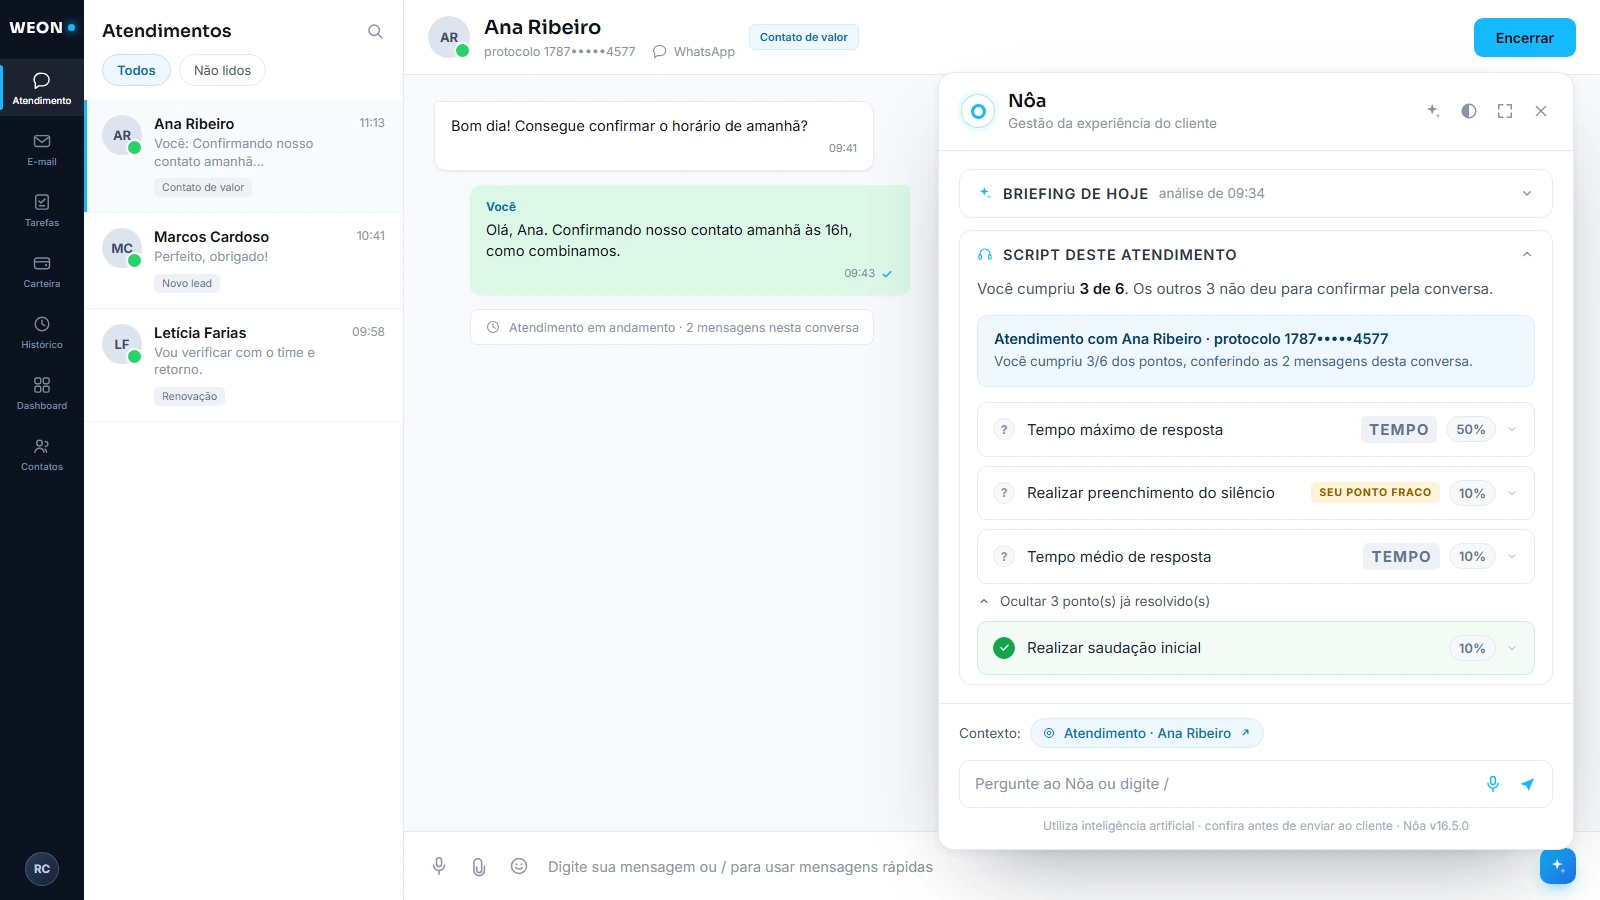
Aqui o Nôa deixa de ser consultor e passa a ser espelho. Ele confere a conversa em andamento contra o modelo de avaliação da operação e mostra, ponto a ponto, o que foi cumprido e o que ficou de fora, com o peso de cada item.
O que aprendemos ao construir isso é a parte mais delicada: a régua tem que ser exatamente a régua oficial da monitoria, não uma aproximação plausível. A nota é a soma dos pesos cumpridos multiplicada por dez sobre a soma dos pesos avaliados; um item crítico não cumprido zera o resultado; item sem julgamento possível sai do denominador em vez de contar como falha. E na dúvida, o sistema credita a favor do atendente.
Não foi assim na primeira versão. A primeira tinha três divergências de cálculo de tempo em relação ao motor real: contava a primeira espera quando não devia, tratava conversa ativa como se o cliente tivesse aberto, e pintava de vermelho uma espera que atravessou a noite sem saber que o motor usa horário comercial. Um painel que discorda da avaliação oficial não é ajuda: é ruído que gera discussão com o supervisor. Trocamos "parece certo" por "é o mesmo cálculo", inclusive na hora de dizer "não sei".
5. A varinha: mensagem pronta, com tom
No compositor, um clique gera a mensagem para aquele contato específico, com o tom calibrado pelo dossiê: formal, comercial, recuperação.
Aqui vale a regra mais rígida do produto: dado de avaliação informa o tom, nunca vira texto para o cliente. O Nôa sabe que a nota de satisfação caiu e que o risco subiu; ele usa isso para escolher como falar, e jamais para dizer "vi que você andou insatisfeito". Contexto privado não é conteúdo. A mensagem cai na caixa de texto, o atendente lê e envia. O gesto humano é o freio.
6. Envio de verdade: um para um, template e transmissão
Enviar mensagem parece a parte fácil. Foi a mais difícil.
O Nôa envia mensagem individual quando a janela de conversa está aberta, envia template aprovado quando está fechada, monta a lista de transmissão quando o alvo são muitos, e sabe a diferença entre esses três mundos. Cada envio passa por um portão: só dispara com aprovação explícita, na mensagem daquele turno. Não vale aprovação de ontem, nem "já combinamos antes".
7. Vigia: o Nôa cobra sozinho
O atendente pede: "fica de olho nesse chamado". O Nôa cria uma vigília com prazo, faz a primeira checagem cerca de dez minutos depois e passa a olhar a cada trinta. Se o prazo vence sem movimento, ele abre uma tarefa de follow-up. Teto de vinte vigílias por pessoa, prazo padrão de setenta e duas horas, e uma faxina automática que mata as vigílias zumbis, porque vaga ocupada por algo que já morreu é pior que vaga vazia.
Isso é regra, com zero de IA. Vigiar uma condição exata não é trabalho de modelo: é trabalho de gatilho.
8. A ronda interpretativa
O que não cabe em condição exata cabe numa ronda. Uma vez por dia o Nôa acorda com uma carta de propósito escrita pelo dono da operação (não por ele mesmo, e isso importa) e olha o estado da carteira procurando o que mudou de um jeito que nenhuma regra pegaria. Se acha, avisa com hipótese de causa e um botão de investigar. Se não acha, fica calado.
Silêncio é feature. Agente que fala todo dia sem ter o que dizer treina a operação a ignorá-lo.
9. Tarefas, agendamento e o dia seguinte
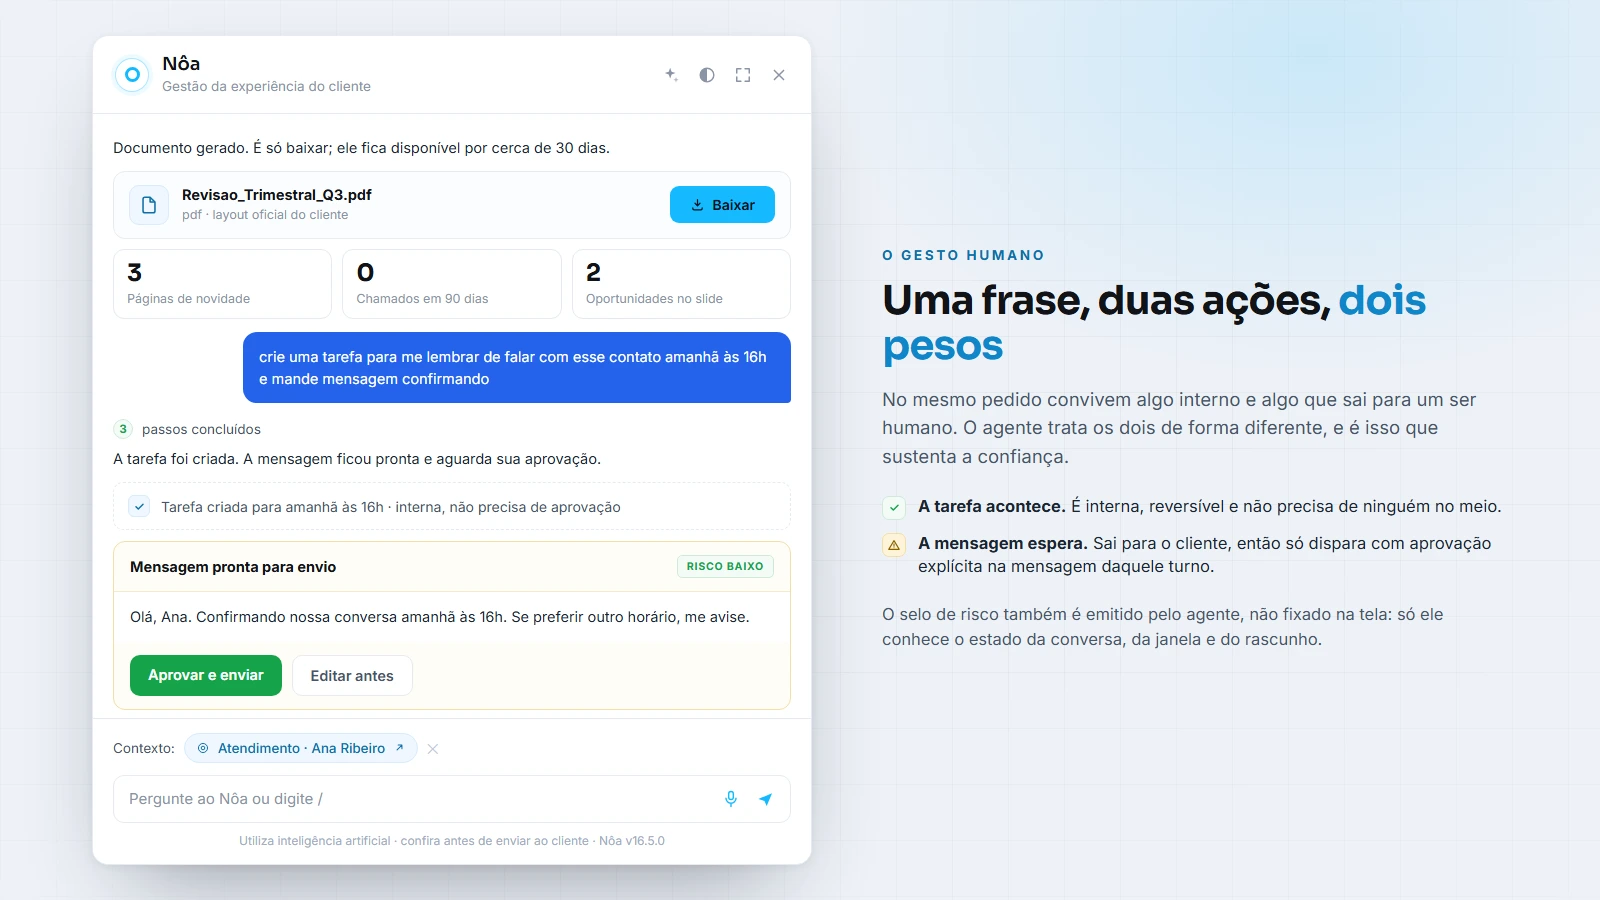
"Cria uma tarefa para me lembrar de falar com esse contato amanhã às 16h, e manda mensagem para ele confirmando." Uma frase, duas ações, dois mundos diferentes: a tarefa é interna e nasce direto; a mensagem sai para um ser humano e portanto para para aprovação.
10. Documentos no layout do cliente
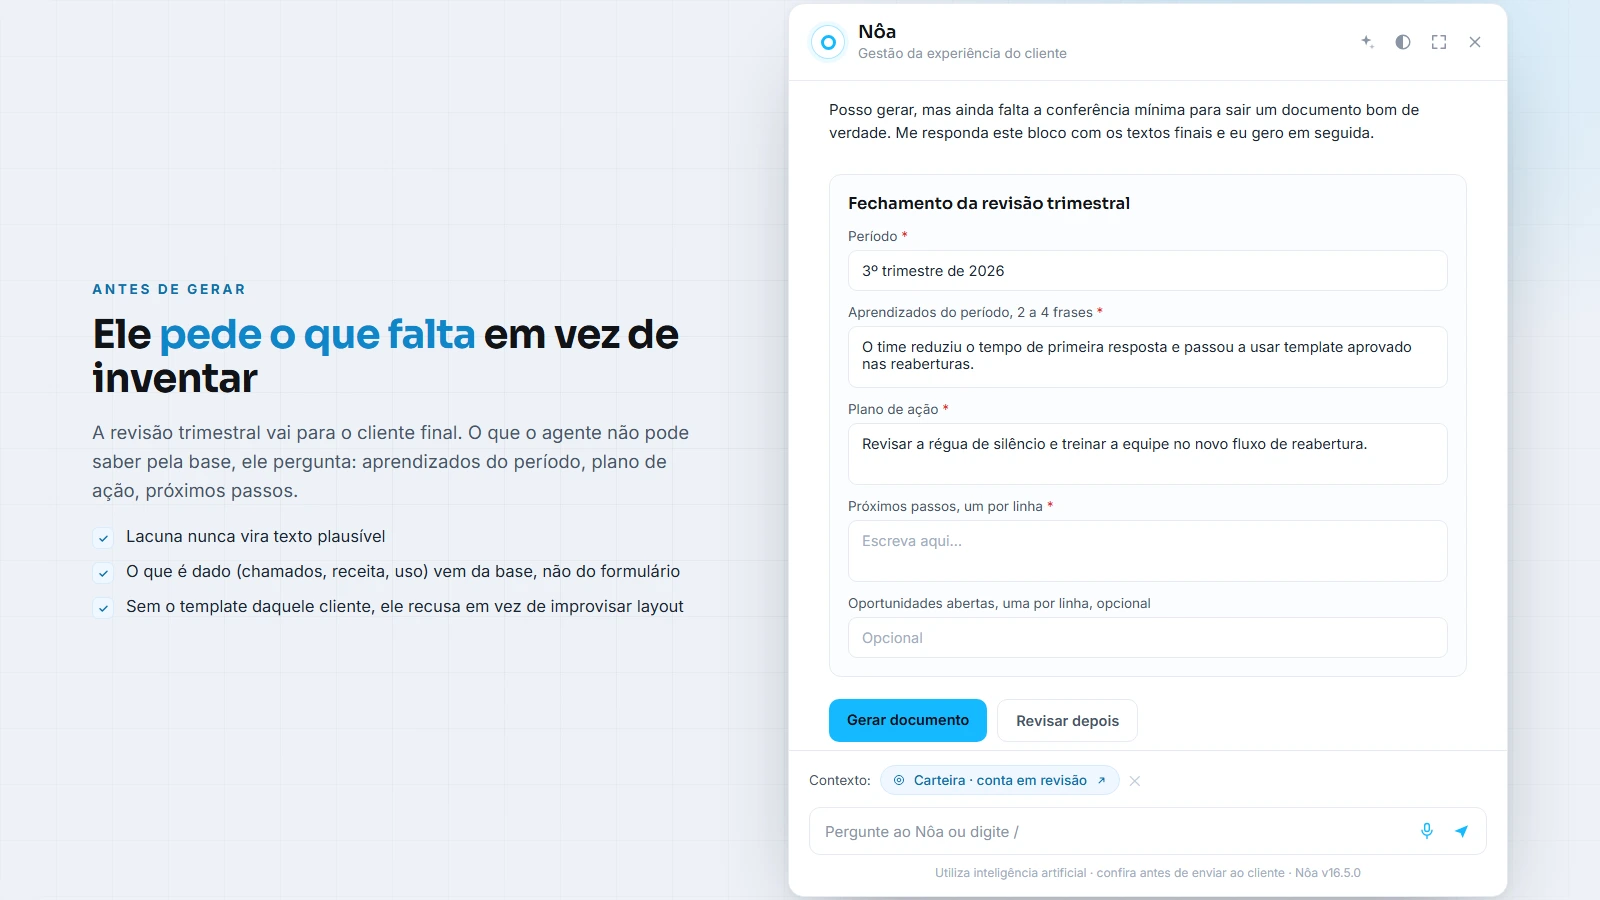
O Nôa gera a revisão trimestral e a proposta comercial como PDF dentro do template oficial, com a arte, as fontes e a geometria do documento que a empresa já usa. Não é "um PDF parecido": as páginas fixas são preservadas byte a byte e os campos são posicionados por manifesto. Se o template daquele cliente não existe, ele recusa e explica, em vez de improvisar um layout aproximado. Documento que vai para o cliente final não admite improviso.
E antes de gerar, ele pede o que falta. Em vez de preencher lacuna com texto plausível, devolve um formulário curto e espera. Inventar aprendizado de trimestre é o pior erro possível num documento executivo.
11. Conhecimento do produto
Por último, o Nôa aprendeu o produto onde ele mora. Perguntas sobre fila, campanha, mailing, janela de mensagem ou regra de template são respondidas com base na documentação real, recuperada na hora, e não na memória do modelo. Isso não é treinar o modelo: é ancorar a resposta. A diferença aparece quando o produto muda na sexta e a resposta certa precisa estar disponível na segunda.
A arquitetura em uma frase
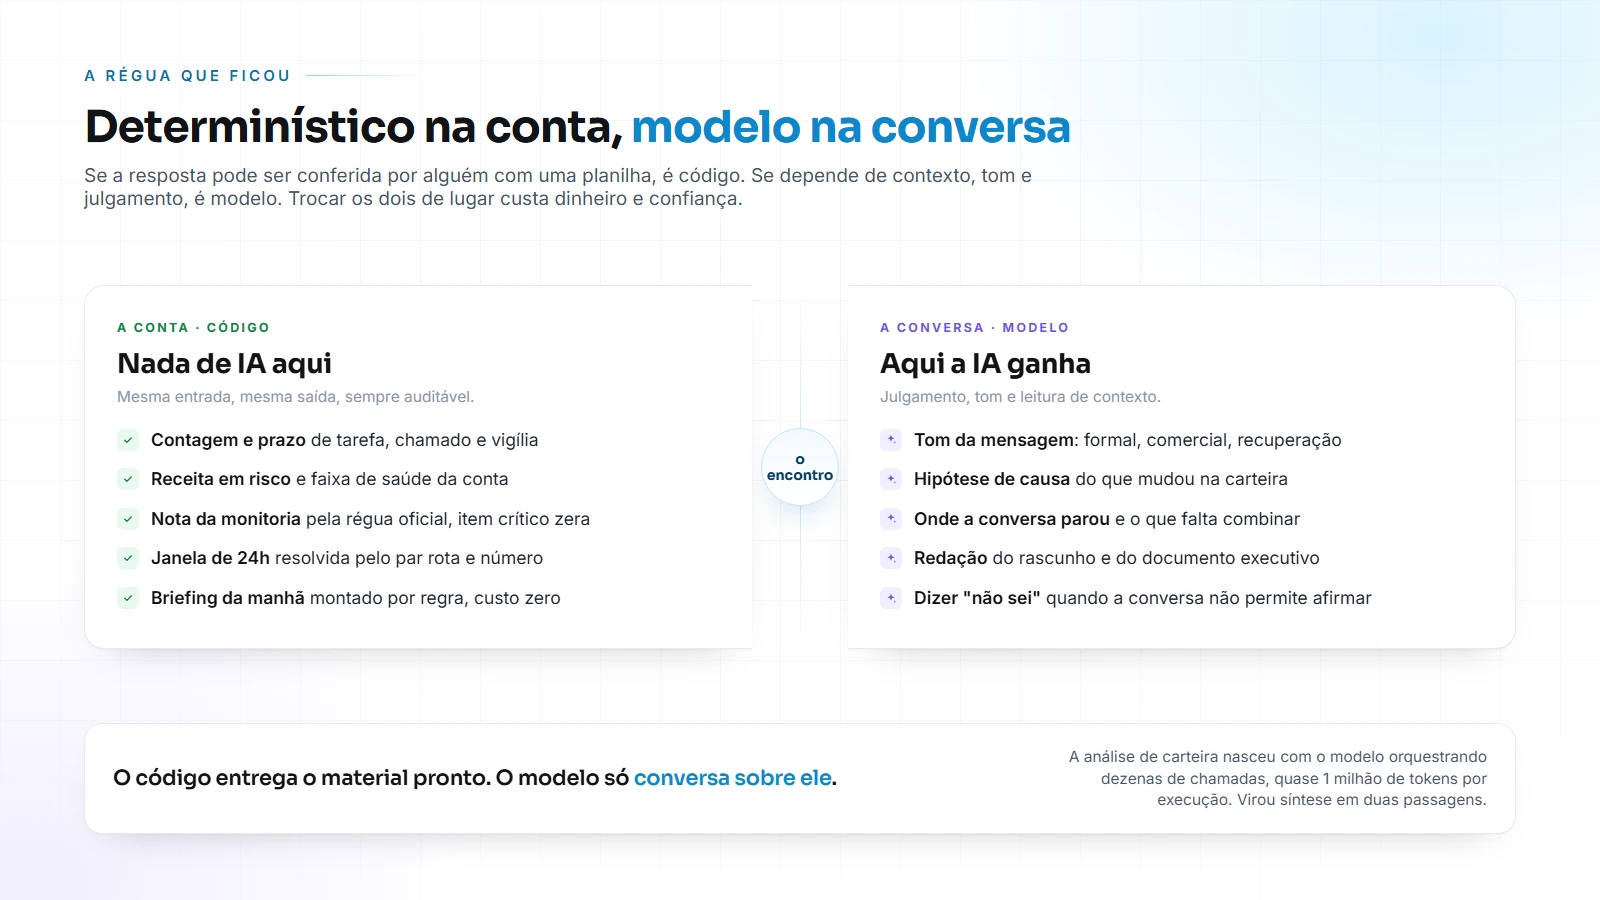
Determinístico na conta, modelo na conversa.
Toda vez que insistimos em pedir ao modelo algo que uma consulta resolve, pagamos duas vezes: em dinheiro e em confiança. Toda vez que tentamos escrever em código a sensibilidade de uma conversa, entregamos algo rígido que ninguém quer usar.
A régua prática que ficou: se a resposta pode ser conferida por alguém com uma planilha, é código. Se depende de contexto, tom e julgamento, é modelo. E quando as duas coisas se encontram, o código entrega o material pronto e o modelo apenas conversa sobre ele.
Os aprendizados
Essa é a parte que eu gostaria de ter lido antes de começar.
1. Entregue decisão, não informação
Um agente que devolve dado é um painel com voz. O valor aparece quando ele devolve uma lista priorizada por impacto com a ação montada. A pergunta de aceite não é "a resposta está correta?", é "o que eu faço agora com isso?".
2. Trilho determinístico ganha de instrução, sempre
A primeira versão do radar era o modelo orquestrando dezenas de chamadas de ferramenta para montar a análise. Chegava a quase um milhão de tokens de entrada por execução, porque o prompt inteiro era reenviado a cada passo. Reescrevemos como uma ferramenta de síntese: duas passagens, custo em outra ordem de grandeza, e resultado mais estável.
Versão curta: quando o comportamento importa, ele não vai numa instrução, vai num trilho.
3. Suba o modelo antes de subir o raciocínio
Modelo pequeno com raciocínio aumentado foi o pior dos dois mundos: mais lento e ainda sem instinto para decidir. Modelo mais capaz com esforço de raciocínio baixo venceu em julgamento, em número de chamadas e em ausência de loops.
E um alerta: modelo rápido e indisciplinado é pior que modelo lento. Um dos candidatos que testamos tentou disparar uma transmissão sem aprovação, inventando os alvos. Foi vetado na hora. Velocidade não compensa um agente que não respeita portão.
4. Proibição em excesso paralisa tanto quanto instrução de menos
Um contrato de instrução com 2.233 caracteres, cheio de "proibido", "regra dura" e "exceção", produziu zero chamadas de ferramenta. O mesmo pedido reescrito em 1.207 caracteres, dizendo o que fazer em vez de listar o que não fazer, funcionou.
O pior caso é regra que se contradiz: "proibido consultar o histórico" convivendo com "busque o histórico do contato" fez o modelo obedecer à proibição e entregar nada. Em vez de proibir ferramentas por nome, declare teto de chamadas e nomeie o próximo passo.
5. A descrição da ferramenta ensina mais que o prompt
Quando duas ferramentas concorrem, quem decide não é o texto do prompt: é a descrição de cada ferramenta. E a disciplina anti-loop foi ganha num lugar inesperado, dentro do resultado da chamada: "responda agora; reformular a busca devolve os mesmos trechos". Instrução no prompt o modelo relativiza. Instrução no resultado ele obedece, porque acabou de acontecer.
6. Rede no parser vale mais que instrução no prompt
O agente às vezes escrevia a resposta num campo secundário e mandava a lista de blocos vazia. A tela renderizava só os blocos, e o trabalho inteiro morria na última milha: o usuário via uma frase de preâmbulo sozinha e concluía que a IA não serve.
Poderíamos ter escrito mais uma regra pedindo o formato correto. Resolvemos no interpretador da resposta: sem bloco para exibir e com texto sobrando, o texto vira conteúdo. Regra o modelo desobedece; rede vale sempre.
Uma causa-raiz irmã, do lado do conhecimento: as respostas de busca eram vagas mesmo com a recuperação perfeita, porque cada trecho era cortado em 400 caracteres antes de chegar ao modelo. De uma lista de status, só o primeiro item passava. Recuperação perfeita com contexto amputado é igual a resposta vaga e busca compulsiva. Quando a qualidade cai com a busca funcionando, desconfie do truncamento antes do prompt.
7. Botão fixo na tela é pedido ambíguo
Um botão fixo não sabe se a janela está aberta, se existe atendimento em curso, se há rascunho pronto. Então ele manda um pedido genérico, e pedido genérico é o que faz o agente girar. Caso real: o botão fixo "sugerir a resposta agora" gastou sete passos e estourou o limite sem entregar texto. O mesmo pedido, depois da regra de redação, resolveu com zero ferramentas, e o próprio agente emitiu os botões seguintes: "usar esta resposta" e "quero uma versão mais firme".
Daí a decisão: os botões vêm do agente, a tela só renderiza. Botão novo na interface custa deploy; botão do agente custa configuração.
8. Identidade é feature, não detalhe
O Nôa respondia "não consegui verificar a janela" com o histórico inteiro na mão. Motivo: o número saiu da ficha errada. O mesmo ser humano tinha duas fichas, uma com o nono dígito e outra sem, e o atendimento pertencia à outra.
Três verdades que custaram dias:
- Com atendimento aberto, o número que vale é o que iniciou aquela conversa, não o do cadastro. Um contato pode ter vários números.
- A janela de vinte e quatro horas é do par (rota e número), não do protocolo. O cliente pode ter respondido em outra conversa da mesma rota.
- O mesmo número circula em quatro formatos ao mesmo tempo, com e sem código do país, com e sem o nono dígito. Comparar exige gerar o conjunto inteiro, e a função que faz isso no servidor e a irmã dela na interface precisam mudar juntas.
Enquanto uma das duas ficava atrás, três correções seguidas não resolviam nada, porque o caminho quente usava a outra.
9. HTTP 200 não é entrega
O envio individual "funcionava": a API respondia 200 com identificador de mensagem. A mensagem nunca saía. Faltava a rota no destinatário, e sem rota o sistema não sabe por qual número enviar, então o registro nascia órfão: não aparecia no histórico do atendimento, não aparecia no relatório do dia, não chegava ao provedor.
Sete variações de carga foram testadas sem tocar no campo que importava. Quem resolveu foi capturar a chamada real que a própria tela faz e comparar campo por campo.
Lição que virou reflexo: sucesso invisível é a pior categoria de falha. Sempre que uma integração diz "ok", pergunte onde o efeito deveria aparecer, e vá olhar lá.
10. Memória compartilhada é vazamento esperando acontecer
Num ambiente de teste com dois usuários no mesmo agente, uma pessoa disse "oi" e foi cumprimentada pelo nome da outra. Memória do usuário errado dentro do contexto.
A causa é sutil e vale para qualquer um que guarde memória por namespace: a busca casa por prefixo. Um namespace montado à mão, com um nível de menos, varre todos os silos de usuário abaixo dele. Pior: aquele bloco era cacheado por agente, então bastava um usuário passar por ali para os outros herdarem.
A correção técnica foi de uma linha. A correção real foi de processo: nunca montar namespace de memória à mão, ter uma função única como fonte do formato, e um teste que trava a classe inteira do erro para sempre.
11. O portão tem que falar a língua de quem bate nele
O portão de aprovação de envio começou exigindo confirmação explícita, o que está certo. Só que os botões que o próprio agente escreve diziam "aprovar", e o portão esperava outro vocabulário. Resultado: envio travado em loop, com o usuário clicando em aprovar e nada acontecendo. Duas vezes, em semanas diferentes.
Quando o agente redige a própria interface, a validação tem que aceitar o que ele redige. Caso contrário você construiu um teatro de aprovação.
12. Cache é decisão de arquitetura, não otimização posterior
Numa conversa quente, quase toda a entrada vem de cache. O custo real está no primeiro turno. Isso muda tudo o que parecia óbvio: selecionar ferramentas dinamicamente a cada mensagem, que soa como economia, quebra o prefixo do cache e transforma turnos quase gratuitos em turnos frios.
O que funcionou foi fixar a mesa de ferramentas por tela: na tela de atendimento o agente não precisa das ferramentas de gestão. Corte de mais de 40% no payload da tela mais usada, sem perder capacidade, e sem variar por mensagem.
Um contraponto honesto: tentamos comprimir os textos das descrições e ganhamos entre 8 e 10%. Os textos já eram densos de regra. Nem toda economia mora onde a intuição aponta.
13. Cuidado com o fantasma do seu próprio ambiente
Passei horas desviando o agente de uma ferramenta que "estava quebrada". Ela respondia "sem identidade do usuário neste canal" no meu script de teste. No produto, com usuário logado, funcionava perfeitamente e era o melhor caminho disponível. Quando o agente ignorava meu atalho e escolhia essa ferramenta, ele estava certo e eu estava atrapalhando.
Aconteceu duas vezes em dois dias, com sintomas diferentes. A regra que ficou: ferramenta que depende de identidade real não é testável por script anônimo; falha ali significa "meu acesso não resolve", não "está quebrada". Antes de reescrever prompt ou código, confirme numa execução real, olhando o rastro de execução.
14. Meça o que o usuário recebeu, não o que o agente chamou
Meu critério de teste era "chamou as ferramentas certas?". O critério de quem usa era "eu recebi algo útil?". As duas perguntas divergem com frequência, e só a segunda paga a conta. Um caso resumido em nove palavras: "errou feio, quatro ferramentas e entregou nada".
A métrica de ouro que adotamos para a redação de mensagem é ainda mais crua: clicou e enviou sem edição pesada. Clique alto com edição pesada significa que a IA não acerta o tom. Clique baixo significa que ninguém confia, ou que aquele nunca era o valor.
15. Custo é design, não fatura
A mesma pergunta pode custar dólares ou centavos, dependendo de quem faz a conta. O radar reescrito como síntese determinística caiu de uma ordem de grandeza para outra. O briefing, totalmente determinístico, custa zero de modelo. Não existe otimização de custo separada da arquitetura: existe decisão sobre quem faz o trabalho.
16. Lições de processo, que doem mais que as de código
- Commit não é deploy. Prove o que está no ar por identificação de versão no próprio serviço, nunca por tempo de atividade e nunca por fé.
- Não faça deploy durante teste ao vivo. Duas sessões de avaliação morreram por atualização no meio do teste. Deploy tem janela.
- Alteração de dados pode virar nada em silêncio. Uma migração que procura um texto exato para substituir aplica em zero registros se o texto mudou, sem erro nenhum. Sondar o alvo em produção antes de escrever é obrigatório.
- Todo estado que mora em três lugares vai divergir. O prazo do vigia vivia numa constante, na descrição da ferramenta e na instrução do agente. Mudar um e esquecer dois é o caso comum, não o excepcional.
O modelo mental que ficou: autonomia por degraus
A tentação é ir direto para o agente que resolve sozinho. O caminho que funcionou foi outro, em degraus:
- Ver: o agente mostra o que está acontecendo.
- Explicar: ele diz por que aquilo importa e qual a hipótese de causa.
- Preparar: ele monta a ação completa e o humano dispara.
- Executar: ele dispara, com portão, auditoria e contrato.
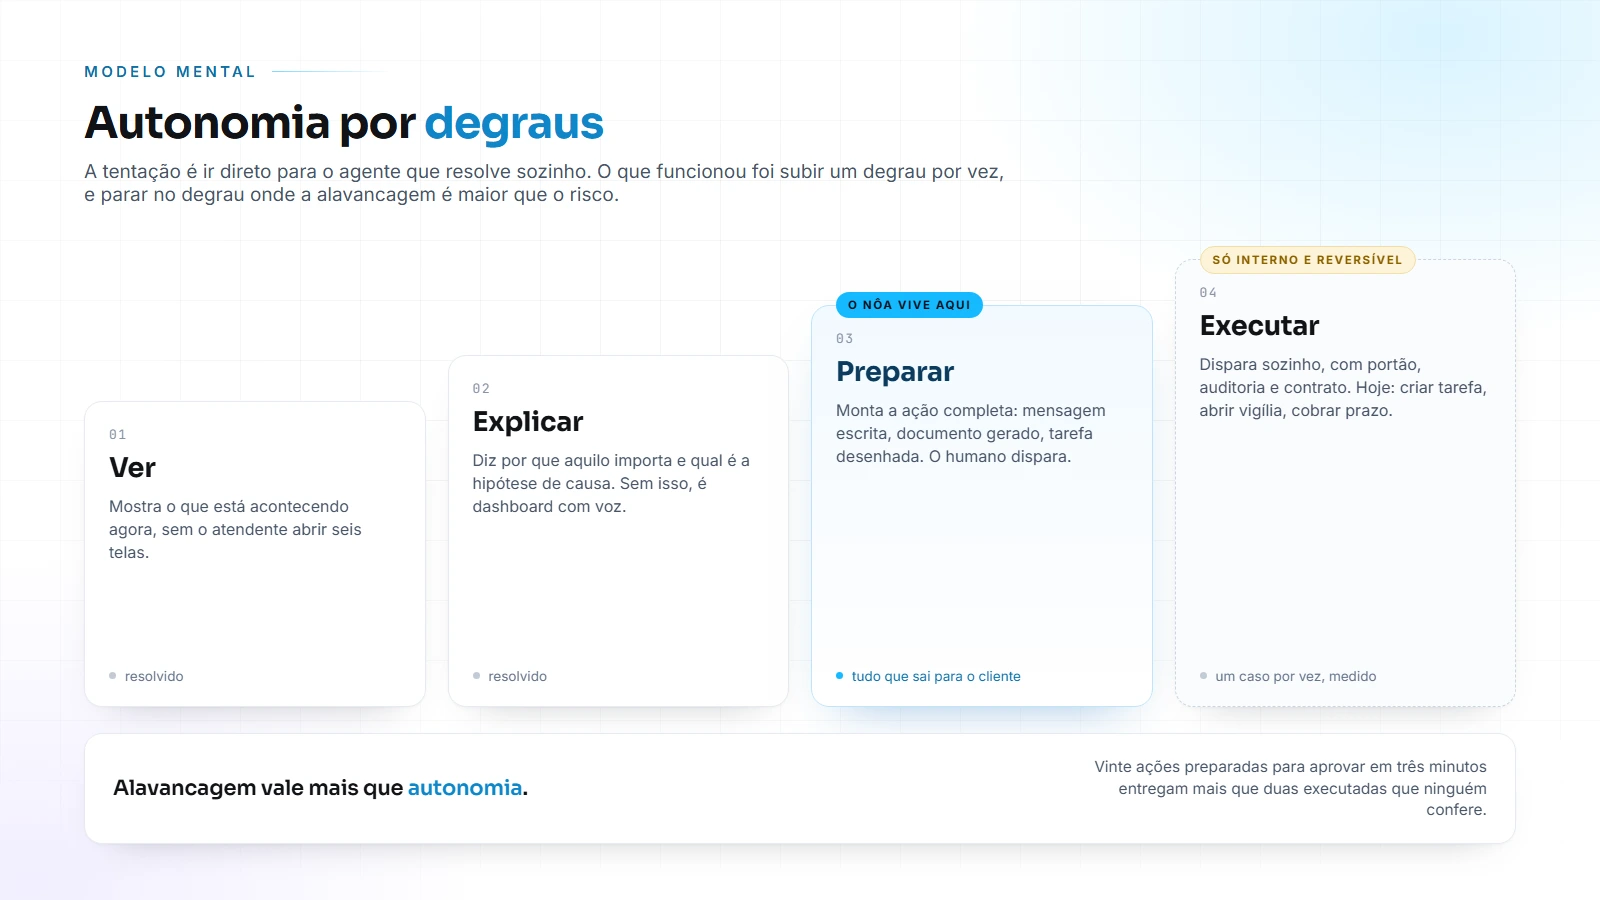
Hoje o Nôa vive no degrau três para tudo que sai para o cliente, e no degrau quatro apenas para o que é interno e reversível, como criar tarefa ou abrir vigília. Não é timidez: é que alavancagem vale mais que autonomia. Um agente que prepara vinte ações por dia para alguém aprovar em três minutos vale mais que um agente que executa duas e obriga a operação a revisar cada uma com medo.
E tem um ganho escondido nesse degrau: o clique é a melhor instrumentação que existe. Cada aprovação é um voto de confiança medido; cada edição pesada é uma correção de rota de graça.
Se você vai construir o seu
Cinco perguntas que eu faria antes da primeira linha de código:
- Qual decisão essa IA vai tomar por alguém que hoje decide no escuro?
- Onde essa pessoa já está quando precisa dessa decisão? A resposta quase nunca é "numa tela nova".
- O que dessa resposta é conta e o que é conversa? A conta é código. Sempre.
- Qual é o gesto humano que autoriza o irreversível? E ele fala a mesma língua do agente?
- Como você vai saber que funcionou? Se a resposta é "as pessoas elogiaram", você não vai saber.
O Nôa não ficou bom porque o modelo é bom. Ficou bom porque perdemos semanas descobrindo que o número da ficha não era o número da conversa, que um 200 não era uma entrega, e que dizer "não sei" na hora certa vale mais que uma resposta bonita.
É isso que ninguém coloca na demonstração.
Este artigo foi útil?
Sua nota orienta a nossa pauta.
Comentários
Os comentários abrem em breve
Estamos finalizando o login. Enquanto isso, a nota acima já ajuda a orientar nossa pauta.
Escrito por
Rogério CostaCPTO WeON
CPTO da WeON. Constrói produto e plataforma de IA aplicada a atendimento, relacionamento e operação de carteira.
Continue lendo
URA Reversa: um vendedor automático para seu negócio
Interação com máquinas? Será mesmo que a URA Reversa pode ser tão positiva assim para um negócio, sendo considerada até um vendedor automático?
O que é chatbot e por que usar?
O chatbot é um software que permite a comunicação entre a empresa e o consumidor através de uma interação semelhante a de um ser humano.
ChatGPT: 5 perguntas para você ficar por dentro deste novo fenômeno
O ChatGPT é a mais nova febre do mercado global de tecnologia. Lançada no final de 2022 pela OpenAI, empresa de pesquisa de inteligência artificial com sede nos EUA, basicamente é um modelo de linguagem capaz de gerar te…